O post técnico publicado em 10 de setembro de 2026 detalha como a equipe da Hugging Face implementou um pipeline de treinamento assíncrono para reinforcement learning (RL) com LoRA, usando Jobs do Hugging Face e sem a necessidade do NCCL para sincronização de pesos.
Arquitetura: buckets e proxies no lugar de clusters
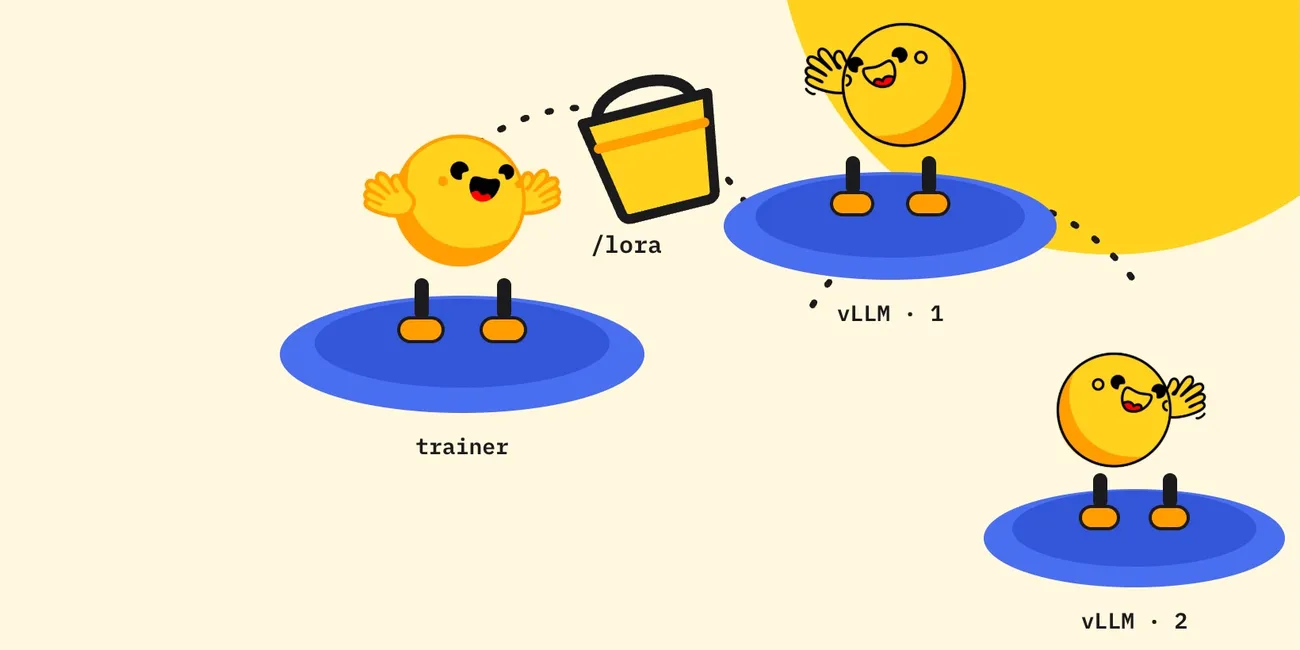
O AsyncGRPOTrainer, agora compatível com LoRA (desde o TRL v1.14), permite treinar apenas o adapter LoRA e sincronizá-lo com réplicas de vLLM para inferência. O grande diferencial é que um adapter LoRA de rank-1 ocupa apenas alguns megabytes, enquanto o modelo completo chega a vários gigabytes. Isso torna viável a sincronização usando Storage Buckets compartilhados entre diferentes Jobs, em vez de uma rede de alta velocidade típica de clusters tradicionais.
Cada componente roda em seu próprio Job — containers independentes em VMs separadas. O treinamento ocorre em um Job; a inferência, em outros dois, cada um servindo o modelo base com o adapter mais recente. Um Storage Bucket é montado via FUSE como volume em todos os Jobs, servindo de sistema de arquivos compartilhado. O proxy, também rodando como Job, gerencia o roteamento dos rollouts para as réplicas corretas e garante que todas estejam com o adapter atualizado.
Por que LoRA é chave para RL distribuído
O uso de LoRA para RL foi fundamentado por resultados do blog “LoRA Without Regret” da Thinking Machines, mostrando que adapters de rank-1 já são suficientes para absorver as informações de política em RL, dada a baixa quantidade de informação útil por episódio. Isso permite que o pipeline sincronize apenas os adapters, não o modelo inteiro, tornando o processo muito mais leve e tolerante à infraestrutura limitada dos Jobs.
Ganhos práticos e limitações
Em testes relatados, o pipeline reduziu o tempo de 500 steps de 3 horas e 27 minutos para 53 minutos, apenas trocando o método de sincronização. O setup não exige alterações profundas no TRL ou vLLM: o trainer salva o adapter no bucket, as réplicas de vLLM leem do mesmo caminho e carregam o novo adapter via endpoint padrão. O proxy adiciona headers de autenticação, roteia requests conforme o cache de KV de cada réplica, e faz o broadcast das atualizações.
O modelo escala até o limite de GPUs por Job (8x H200) e depende da performance do Storage Bucket e do proxy para manter a consistência e throughput. Jobs são efêmeros, mas a persistência dos adapters no bucket permite retomar o treinamento mesmo após preempção.
Para quem serve
A solução é ideal para times que querem rodar RL em larga escala usando a infraestrutura gerenciada do Hugging Face, sem montar clusters tradicionais. O ganho é maior para workflows em que o modelo base é pesado, mas as mudanças a cada step são pequenas e podem ser encapsuladas em adapters.
Para ambientes que já contam com clusters com NCCL e discos compartilhados de alta velocidade, a vantagem diminui. A arquitetura também exige conhecimento de sistemas distribuídos para configurar proxies e buckets corretamente.
Nota
O pipeline AsyncGRPOTrainer + LoRA para Jobs do Hugging Face recebe nota 4.0: é uma solução eficiente e moderna para RL distribuído, mas exige configuração cuidadosa e não elimina todos os desafios de consistência e performance em ambientes de produção.