FastBench: benchmark avalia VLMs em streaming de vídeo de alta dinâmica
Novo benchmark testa VLMs com vídeos reais de alta dinâmica. Modelos líderes como Gemini-3.5-Flash ficam abaixo de 51%. Ganhos com sampling denso saturam rápido.
Medições, comparações e dados sobre capacidade dos modelos.
35 edições arquivadas
Novo benchmark testa VLMs com vídeos reais de alta dinâmica. Modelos líderes como Gemini-3.5-Flash ficam abaixo de 51%. Ganhos com sampling denso saturam rápido.
O benchmark WOVEN revela limitações sistemáticas de modelos multimodais em raciocínio sobre transições visuais. Mesmo os modelos mais avançados ficam distantes do desempenho humano.
Avaliação sistemática mostra que Jev e outros modelos de decisão zero-shot não superam LLM-as-a-judge ou classificadores pequenos customizados em guardrails de IA.
Comparativo direto entre GPT-5.6 Luna e GPT-6 Astra revela trade-off entre custo e precisão em revisão de código automatizada. Luna custa 28x menos, mas perde em bugs de segurança.
Novo estudo mostra que sistemas de reconhecimento de voz tendem a repetir erros dos benchmarks públicos em vez de seguir o áudio real. Efeitos de 'benchmaxxing' em 11 modelos open-source.
Benchmark ConceptGuard propõe avaliar a capacidade de LLMs esquecerem conceitos de uso duplo sem perder utilidade, revelando limitações das técnicas atuais.
Novo MLLM focado em visão médica lidera em 20 de 24 benchmarks abertos, com desempenho superior a modelos como Hulu-Med, Lingshu, GPT-5.2 e Gemini-3-Flash em tarefas clínicas.
LKValues apresenta benchmark e corpus de instruções para testar e alinhar LLMs com valores sociais do Sri Lanka, destacando desafios multiculturais em IA.
Análise de 12.750 artigos mostra que 32% dos textos submetidos ao arXiv soam como escritos por IA, com variação acentuada entre áreas. Computer science lidera com 65%.
Equipe liderada por Nirjhar Das conquista o topo do QANTA 2026 com arquitetura dual baseada em GPT-4o-mini e estratégias calibradas para tossup e bonus.
Novo sistema de tradução de língua de sinais atinge BLEU 15.9 e BLEURT 44.7 em sentenças completas, com latência reduzida em 27%. Stack usa SHuBERT-ByT5 e streaming otimizado.
LACUNA introduz a primeira suíte de benchmark com ground-truth para avaliar se métodos de unlearning realmente removem dados sensíveis dos parâmetros do modelo.
Novo benchmark da IBM Research expõe baixa taxa de sucesso de agentes de código em migração entre frameworks Java. Menos de 10% preservam comportamento.
Experimento da AllenAI mostra que modelos híbridos superam transformers em tokens de conteúdo, mas perdem vantagem em repetições e estruturas fechadas.
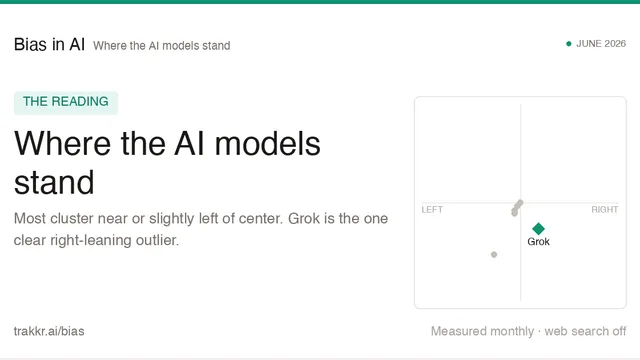
Análise da Trakkr mostra que ChatGPT, Claude, Gemini, Grok, Llama e DeepSeek apresentam leves inclinações políticas em testes padronizados, com Grok à direita e ChatGPT à esquerda do centro.
Avaliação com GPT Realtime 2, Gemini 3.1 Flash Live e Qwen3.5 Omni Plus mostra que sistemas de voz ignoram tom emocional mesmo quando reconhecem sentimentos.
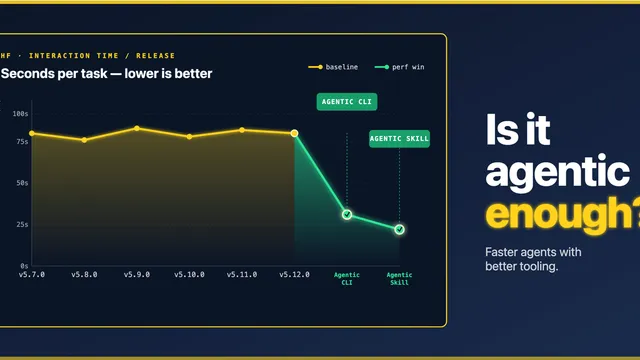
Hugging Face testa agentes em tarefas reais usando diferentes revisões do transformers. Novo benchmark avalia não só o acerto, mas o esforço do agente.
Novo benchmark mostra que idade, tipo físico e estilo de moda são os principais motores de vieses sociais em modelos multimodais. Dataset controlado isola efeito de atributos visuais individuais.
Estudo testa 8 LLMs em problemas clássicos e contraintuitivos de probabilidade. Precisão cai de 96% para 59% em exercícios que desafiam heurísticas.
Novo método Code2LoRA usa hypernetworks para gerar adapters LoRA específicos por repositório, superando abordagens tradicionais em benchmark com 604 projetos Python.
OpAI-Bench propõe avaliação inédita da detecção de autoria IA em textos editados por humanos e IA, analisando granularidades de documento a token e revelando padrões não monotônicos.
Novo ambiente ClinEnv mede como LLMs atuam como médicos em cenários reais de internação, avaliando tanto decisões quanto o processo de coleta de informações.
Estudo mostra que LLMs open-source de porte médio conseguem captar semântica de construções raras como 'let alone', sugerindo avanço além da mera sintaxe.
Novo benchmark PEFT-Arena mede trade-off entre adaptação e retenção em técnicas de finetuning eficiente. Análise mostra vantagens do orthogonal finetuning.
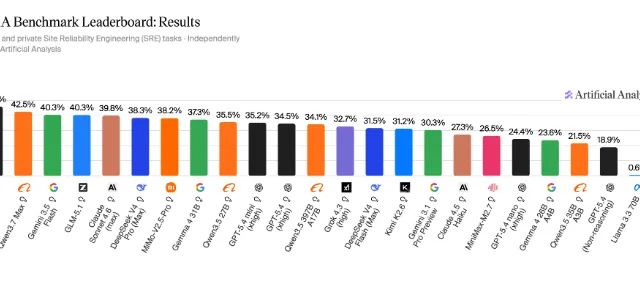
Primeira rodada do ITBench-AA avalia LLMs em diagnósticos complexos de Kubernetes. Nenhum modelo supera 47%. Claude Opus 4.7 lidera, seguido por GPT-5.5 e Qwen3.7.
Estudo testa seis chatbots comerciais em 2.100 perguntas factuais de notícias BBC. Líderes atingem 90% de acerto, mas desempenho cai para idiomas não-ingleses e questões com premissas falsas.
Benchmark de maio mostra modelo de 3B parâmetros da DharmaAI vencendo Claude, GPT-5 e Google Vision em OCR estruturado de documentos brasileiros, com custo operacional 52 vezes menor.
Novo benchmark FutureSim testa agentes de IA em previsões de notícias reais, simulando eventos entre janeiro e março de 2026 e revelando limitações nas capacidades de adaptação.
Benchmark compara grep e retrieval vetorial em workflows agenticos com LLMs. Grep tem desempenho superior, mas resultado depende do harness e estilo de chamada de ferramenta.
EVA-Bench propõe avaliação de ponta a ponta para agentes de voz, com métricas inéditas de precisão e experiência. Framework cobre 213 cenários e três arquiteturas.
Novo levantamento Gallup mostra que jovens americanos estagnaram no uso de IA, ampliaram desconfiança e preferem serviços humanos, mesmo reconhecendo ganhos de produtividade.
Avaliação do Deep Agents mostra GLM-5 e MiniMax M2.7 próximos de Claude Opus 4.6 e Gemini 3.1 Pro em file ops, tool use e instruções, com custos menores.
Novo método formaliza auditorias comparativas de segurança para LLMs mesmo sem benchmarks rotulados. Estudo de caso com modelos Borealis e Gemma 3.
Estudo mostra que LLMs trazem sinais internos de gramaticalidade, superando a simples probabilidade de string em benchmarks de julgamento gramatical.
Estudo com 14 LLMs mostra queda brusca de acurácia ao executar algoritmos aritméticos extensos. Desempenho cai de 61% para 20% em tarefas com até 95 etapas.