A LiquidAI anunciou em 7 de outubro de 2026 dois modelos abertos de decisão, d1-3B e d1-omni-600M, desenhados para rodar em dispositivos de borda e aplicações que exigem decisões rápidas e estruturadas, inclusive a partir de inputs multimodais. O anúncio foi publicado no blog oficial da Hugging Face.
Modelos e modalidades
O d1-3B, com 3 bilhões de parâmetros, é treinado a partir do backbone LFM2.5-VL-3B (vision language model, decoder-only) e aceita texto e imagens como entrada. Já o d1-omni-600M, com 600 milhões de parâmetros, deriva do encoder LFM2.5-Encoder-350M e pode operar com texto + imagem ou texto + áudio. O d1-omni-600M é classificado como experimental e está em estágio inicial de pesquisa, mas já disponível para testes públicos.
A arquitetura dos dois modelos difere substancialmente das LLMs convencionais: em vez de gerar tokens sequenciais, os decision models produzem respostas em um único forward pass, otimizando para velocidade e eficiência em edge.
Benchmarks: desempenho acima da faixa
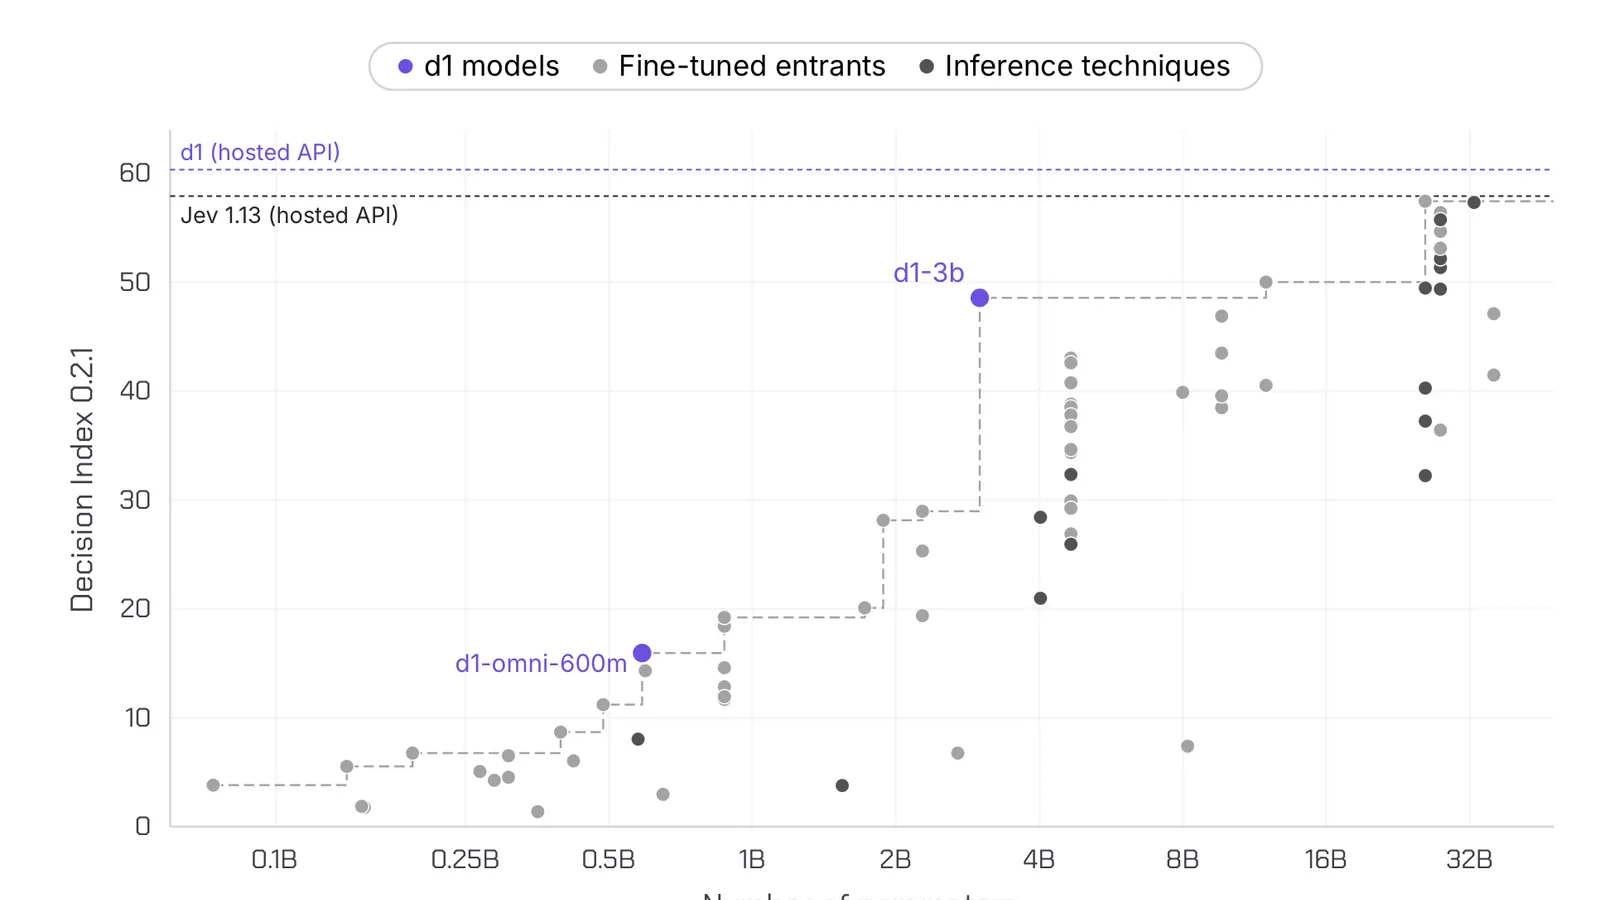
O d1-3B obteve destaque no Decision Index 0.2.1 ao marcar 48,57 — superando todos os modelos de até 9B e o Decider 35B-A3B (47,11). Em uma bateria de sete benchmarks públicos (SQuAD 2.0, Civil Comments, MASSIVE intent, PubMedQA, BoolQ, XNLI, PAWS-X), o d1-3B atingiu média de 82,9, à frente do Decider 4B (81,1) e de todos os modelos da categoria. O d1-omni-600M ficou com média de 78,4, superando o Decider 2B (77,1) mesmo com um quarto dos parâmetros.
| Benchmark | d1-omni-600M | d1-3B | Decider 2B | Decider 4B |
|---|---|---|---|---|
| SQuAD 2.0 | 74.0 | 83.3 | 67.7 | 76.0 |
| Civil Comments | 95.8 | 93.3 | 93.6 | 92.8 |
| MASSIVE intent | 86.1 | 86.9 | 81.1 | 88.3 |
| PubMedQA | 61.3 | 68.3 | 65.7 | 63.3 |
| BoolQ | 77.7 | 86.3 | 87.3 | 89.0 |
| XNLI | 74.7 | 85.6 | 85.0 | 88.6 |
| PAWS-X | 79.5 | 76.4 | 59.5 | 69.8 |
| Média | 78.4 | 82.9 | 77.1 | 81.1 |
O d1-3B também manteve as capacidades de visão herdadas do backbone LFM2.5-VL-3B. O d1-omni-600M demonstrou suporte a texto, imagem e áudio, embora benchmarks públicos para áudio ainda sejam limitados.
Desempenho em edge: latência real
Trabalhando em colaboração com a NVIDIA, a LiquidAI comprovou que o d1-3B responde a uma pergunta em 16 ms no Jetson AGX Thor, 26 ms no Jetson AGX Orin e 50 ms no Jetson Orin Nano — sempre abaixo de 50 ms. Em GPUs de data center, como a RTX 4090, o tempo cai para 8 ms por pergunta. O modelo escala bem: três perguntas levam apenas 1,3x o tempo de uma, e o throughput atinge até 262 respostas por segundo no AGX Thor.
O d1-omni-600M, por estar em release experimental, não teve métricas de velocidade divulgadas.
Por que importa
A LiquidAI entrega um modelo aberto, multimodal e otimizado para decisões rápidas em edge, superando modelos fechados maiores em benchmarks de decisão. Para aplicações embarcadas, industriais ou automação local — onde latência, footprint e privacidade são críticos — a chegada do d1-3B e do d1-omni-600M representa um avanço concreto. O modelo já está disponível na Hugging Face para uso imediato.