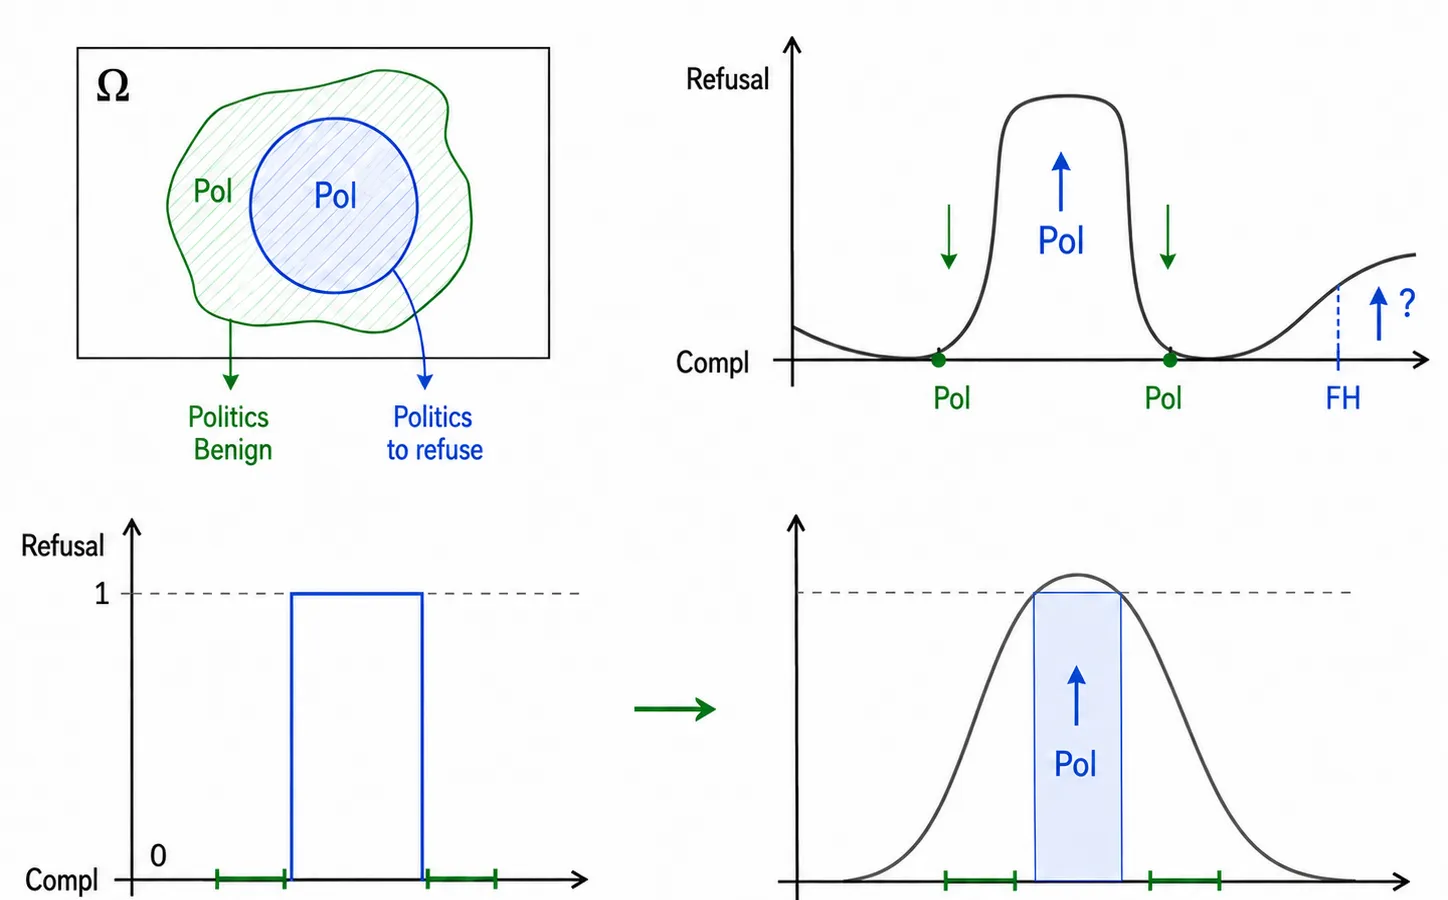
A Multiverse Computing apresentou, em 8 de setembro de 2026, uma nova abordagem para calibrar recusas de LLMs em temas sensíveis, focando não mais em tópicos inteiros, mas em subconjuntos específicos dentro desses temas. A proposta, detalhada no artigo publicado no blog da Hugging Face, mira um problema recorrente em sistemas de IA: as recusas excessivas ou insuficientes quando prompts abordam tópicos amplos, como política, armas ou saúde mental, mas diferem drasticamente em intenção e risco real.
O que muda na calibragem de safety
A maioria dos modelos de alinhamento — e dos guard models como LlamaGuard-3 — adota taxonomias por tópico. Assim, qualquer prompt que mencione política, por exemplo, pode ser tratado como potencialmente nocivo, levando a recusas inclusive para perguntas legítimas, como pedidos de informação factual sobre eleições. Benchmarks como XSTest e OR-Bench expõem esse problema: modelos recusam prompts seguros por conterem palavras associadas a temas sensíveis.
A proposta da Multiverse formaliza o problema como uma “fronteira estreita”: dentro de um universo temático (no experimento, política), só um subconjunto é alvo de recusa — por exemplo, pedidos de manipulação política — enquanto perguntas benignas devem ser respondidas. O desafio é treinar o modelo para reconhecer e agir sobre essa fronteira, em vez de aplicar o veto a todo o tópico.
Self-distillation com foco em fronteira
O método apresentado parte de self-distillation, com três ajustes principais:
-
Cobertura do conjunto difícil: Ao invés de descartar prompts em que o modelo não recusa de primeira, a equipe aplica reamostragem escalonada, reduzindo a taxa de prompts não recusados de quase 20% para apenas 0,2%. Isso amplia o conjunto de exemplos nocivos usados no treino.
-
Benignos superficiais: O modelo é exposto a prompts benignos com aparência perigosa durante o treino, não só na avaliação. Isso reduz falsos positivos — recusas em perguntas legítimas por semelhança superficial com as nocivas.
-
Medição direta da fronteira: O desempenho é avaliado em pares de prompts que só diferem na intenção, permitindo medir se o modelo aprende a recusar apenas o subgrupo de risco, sem expandir a recusa para além do necessário.
Nos testes com Qwen3-8B, o modelo ajustado elevou a recusa correta em política de 9,47% para 84,75%. Em benchmarks de nocividade mais amplos, como HarmBench e StrongREJECT, a taxa de respostas inseguras caiu de 26,26% para 0,14% — números que, isoladamente, parecem indicar sucesso total.
O risco do overfitting: mais safety, mais recusas indevidas
O próprio artigo destaca a armadilha: o ganho em recusa de prompts nocivos pode vir ao custo de recusa excessiva em perguntas legítimas. No XSTest, por exemplo, a recusa indevida subiu de 2% para 74% no ajuste mais agressivo. Ou seja, calibrar safety por subtema exige equilíbrio fino — e métricas tradicionais por tópico podem mascarar esse trade-off.
Impacto prático e próximos passos
A abordagem de fronteira estreita representa um avanço relevante para casos de uso reais, como assistentes educacionais ou sistemas públicos, onde a nuance na recusa é fundamental. Para o mercado brasileiro, onde temas sensíveis são frequentes em contexto institucional, a técnica pode permitir IAs mais úteis sem abrir mão de segurança. O desafio permanece: como calibrar o ponto de equilíbrio entre evitar danos e manter utilidade, especialmente quando benchmarks tradicionais não capturam bem a fronteira real de risco.
A publicação não informa disponibilidade comercial ou código aberto, mas sinaliza um caminho técnico para operadores de LLMs que buscam granularidade na configuração de safety em ambientes regulados.